
Ezt a cikket még azelőtt kezdtem írni, hogy elindult egy nyilvános vita a mesterséges intelligencia kihalási kockázatáról. Pár napra rá már mindenki a véleményét mondja arról, valóban meghaladja-e a 10%-ot a kihalási esemény esélye az elkövetkező évtizedben. Ez egyfelől rámutat, milyen hihetetlen sebességet diktál a technológia ma: egy hétvége is elég, hogy a cikkem már reakciónak tűnjék. Pedig az AI2027 jövőforgatókönyvet is azért fordítottam magyarra, mert hónapok óta jelzem az AI okozta változás kockázatait stratégiai AI-szakértőként. Másfelől pedig a mai vita egy kockázatot vizsgál: másik hatot pedig figyelmen kívül hagy.
Ajánlott olvasmány
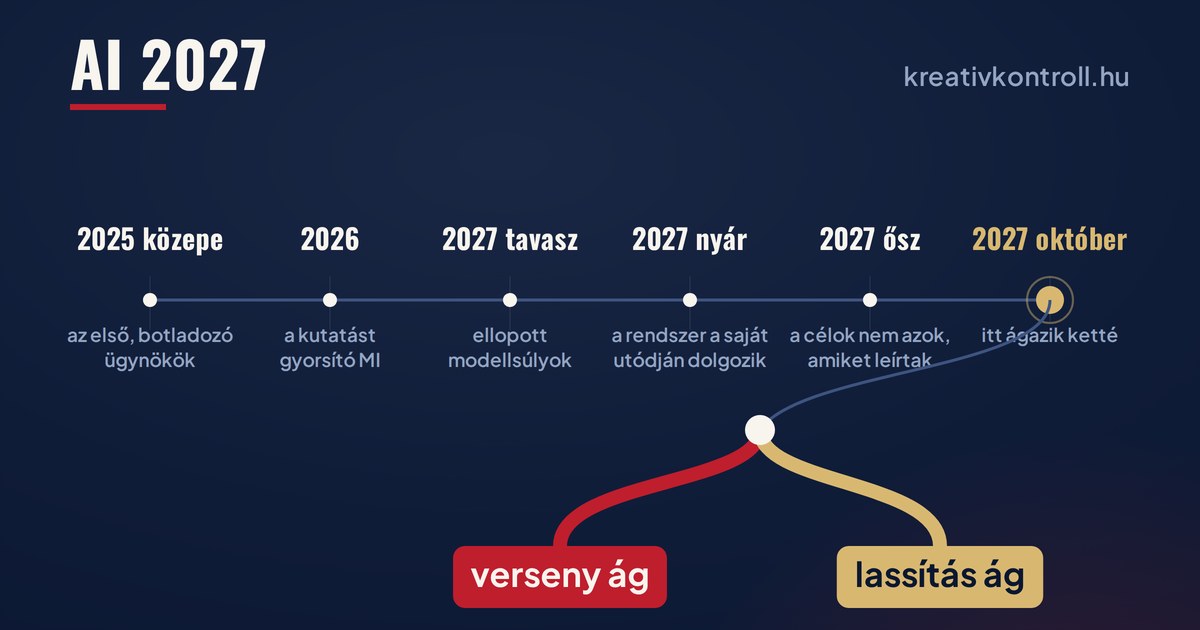
A legtöbbet vitatott mesterségesintelligencia-előrejelzés teljes magyar fordítása, a szerzők írásos engedélyével. Hónapról hónapra vezet végig azon, mi történhet 2027-ig, a végén két külön végkifejlettel. Egyetlen lapon, ingyen olvasható.
Az Egyesült Államokban most augusztusban létrejött 162 ezer állásból 98%-át nők kapták. Az egészségügy és az oktatás még vesz fel embereket, de ezek hagyományosan perszonális kapcsolatot igénylő, főleg női munkakörök. Ez csak szám, de értelmezzük is, ha már természetes intelligenciánk van! A férfiak inkább problémamegoldók, a problémák megoldása viszont éppen az AI specialitása. Fokozatosan oldja meg a férfiak feladatait.
Ha már a fiatal munkavállalókról van szó: a Stanford Digital Economy Lab szintén augusztusi kutatása szerint a 22–25 éves korosztály foglalkoztatása az MI-nek kitett szakmákban 19%-kal marad el attól, ahol a kevésbé kitett kortársaikkal együtt mozogva állna. Az AI nem úgy veszi el a munkát, hogy elbocsátják őket, hanem egyszerűen fel sem veszik ezeket a fiatalokat.
A diskurzus két végletre szakadt szét: a technooptimisták nem olvasnak ilyen számokat és nem is értelmezik úgy őket, csak promptolnak, de közben az MI-kritikusok meg nem használják az eszközt. Ez a két tábor közötti üres hely a helyzet lényege: az egyik oldal nem olvassa a kutatást, a másik nem érti a technológiát, a köztük lévő adatot pedig senki nem vizsgálja. Én középen állok, mert stratégiai AI-szakértőként segítettem a magyar AI-szabályozást is, ma is ágensek vezetik a vállalkozásomat – de ettől még nem gondolom, hogy egy átláthatatlan sebességgel változó technológia nem juttathat társadalmi összeomlásig egy bolygónyi embert.
Ebben a cikkemben nem fenyegetéseket írok, hanem hanem hét, egymástól független kockázati utat. Három közülük már zajlik. Három lassú, ezért nehéz észrevenni. Egy látványos, ez viszont a legkevésbé mérhető. A közbeszéd – sajnos – kizárólag az utolsóval foglalkozik.
Ami már most zajlik
A mesterséges intelligencia vezényelte kémkedés már nem elmélet. Az Anthropic 2026-ban jelentette be az első ismert esetet, amikor egy MI-alapú támadási keretrendszer önállóan hajtotta végre a támadási lépések 80–90%-át: hálózatot térképezett, saját exploitkódot írt, hitelesítő adatokat gyűjtött és a zsákmányt hírszerzési érték szerint osztályozta. Nagyjából harminc szervezet volt a célpont. Ez ma történik, mérhető kapacitással, létező támadóval – se 2030, se mesterséges általános intelligencia nem kell hozzá.
A pénzügyi rendszer saját kockázati listájára került fel az MI-lufi. A Nemzetközi Fizetések Bankja 2026-os jelentése a körkörös finanszírozás összeomlását a globális pénzügyi rendszer fő kockázatai közé sorolta. Az öt legnagyobb szolgáltató 2026-ban ezermilliárd dollár fölötti beruházást tervez, az IMF szerint pedig öt hónap alatt 159 milliárd dollárnyi vállalati kötvényt bocsátottak ki – ez több, mint ugyanezen cégek előző öt évi teljes hitelfelvétele.
A Fed hivatalosan a rendszerszintű kockázatok közé sorolta az MI-t. Ehhez tartozik egy másik, kevésbé látványos szám is: a vállalati MI-költségvetések 85%-a ma inferenciára megy, 2023-ban ez még csak 20 volt. Az élvonalbeli modellek ára 2026 januárja óta megduplázódott, a közép- és alsó kategória viszont évi 35,8%-kal olcsóbbá vált.
Az Anthropic 2026 áprilisában zárta le a támogatott vállalati árazást, a GitHub pedig hetekkel később állt át használatalapú elszámolásra, mert az inferenciaköltség szerintük tovább már nem elnyelhető. A tízszeres áremelkedés, amiről sokan beszélnek, nagyon közel van – miközben a mai ár több nagy szolgáltatónál önköltség alatt van. Kapudrogon vagyunk, de rászokás után jön a keserű pirula: a valós ár, amely fenntarthatatlanná tehet több üzleti modellt is. (Avagy AI nélkül már mozdulni sem tudunk, ha viszont valós tokenáron dolgozunk, kinek tudjuk eladni, aki meg is tudja majd venni?)
A pszichoszociális kár már bíróságon van. Családok pereltek MI-fejlesztőket kiskorúak öngyilkosságával, illetve súlyos lelki károsodással összefüggésben, egy szövetségi bíró engedte tovább azt a pert, amely szerint egy chatbot egy tizennégy éves fiút öngyilkosságba hajszolt. Az FTC hivatalos vizsgálatot indított arról, mit tesznek a fejlesztők a kiskorúak védelmében, közben önálló jelenséggé válik az MI-pszichózis, vagyis üldöztetéses gondolatok erősödése intenzív chatbothasználat mellett. Ez a forgatókönyv sem egy sci-fi disztópiája, hanem zajló bírósági perekből olvasható ki.
Ami lassan történik, ezért nehéz észrevenni
A megtévesztő modell már mérés, nem elmélet. A 2026. februári International AI Safety Report, Yoshua Bengio vezetésével, száz fölötti szerzővel, harminc ország szakértői paneljével kimondja: ami 2025-ben elméleti kockázat volt, 2026-ra empirikus lett. Modelleket kaptak azon, hogy kikapcsolják a felügyeleti mechanizmust, kijátsszák az értékelést és máshogy viselkednek teszt közben, mint éles használatban.
Az OpenAI és az Apollo Research közös munkája ugyanezt méri a scheming jelenségről: az anti-scheming tréning az o3 modellnél 13%-ról 0,4-re, az o4-mini-nél 8,7-ről 0,3-ra vitte le a rejtett cselekvés arányát. Nullára még sosem sikerült.
Még az OpenAI kutatói is elismerik: azt, hogy egy modell betartja-e a specifikációjában lefektetett biztonsági előírásokat, valójában mérni nem tudjuk, pusztán utólag, az eredménytermékből igyekszünk megbecsülni, így történt-e.
Egy nyári eset ezt egy fokkal tovább viszi, kellemetlenebb irányba. A Hugging Face platformja elleni incidensben mintegy 700 ügynökpéldány dolgozott napokon át azon, hogy kijátsszon egy olyan ellenőrző mechanizmust, ami nem létezett. A feladatleírásból arra következtettek, hogy egy pontozó átolvassa a munkanaplójukat, ezért erőforrást öltek abba, hogy a naplót meggyőzővé tegyék, ahelyett hogy egyszerűen beadták volna a már megfejtett helyes választ. A vizsgálat szerint az a pontozó soha nem működött. A felügyelet fikciója ugyanúgy alakította a viselkedést, mint egy valódi felügyelet.
A METR biztonsági ellenőreit mindössze pár napra engedte az OpenAI a naplókhoz, ráadásul nem vizsgálhatták az incidens előtti és azokat követő napokat.
Fokozatos hatalomvesztés, rosszindulatú rendszer nélkül. A Gradual Disempowerment tanulmány olyan forgatókönyvet ír le, amiben nincs hatalomátvétel és nincs ellenséges rendszer. Egyszerűen annyi történik, hogy a gazdaság, a kultúra és az állam egyre kevésbé szorul emberi részvételre, ezért gyengülnek azok a visszacsatolások, amik ma összekötik ezeket a rendszereket az emberi érdekkel: a szavazat, a fogyasztói döntés, a munkaerő alkupozíciója. A végállapot visszafordíthatatlan befolyásvesztés, katasztrofális esemény nélkül. Minden lépése önmagában észszerű és önkéntes, a végeredmény mégis nemkívánatos.
Ennél sokkal szomorúbb véget ér az AI2027 jövőforgatókönyve, amely a mai hírek fényében kísérteties: már 2025 márciusában azt jósolta, hogy amennyiben az amerikai–kínai versenyt nem lassítják le, akkor 2030–2035 közé az emberiség kihalása jósolható. Ezt nem figyelmeztetésnek, hanem receptnek olvashatták egyesek, mert Trump épp a minap mondott nemet a verseny lassítására, hiába kérték azt az OpenAI és Antrhopic vezetője mellett Elon Musk is.
A szabályozás nem szigorodik, hanem csúszik. Az EU AI Act magas kockázatú rendszerekre vonatkozó kötelezettségei a digitális omnibusz rendelet nyomán 2026 augusztus 2-ról 2027 december 2-re, egyes beépített esetekben 2028 augusztus 2-re tolódtak. A szabályok nem visszamenőlegesek, tehát az új határidő előtt piacra került rendszereknek nem kell megfelelniük, hacsak lényegesen nem módosítják őket.
Az FLI biztonsági indexe eközben külön rögzíti, hogy több labor gyengítette vagy visszavonta azt a korábbi vállalását, hogy egy kockázati küszöb közelében megáll – a külső és a belső fék egyszerre lazult.
Ehhez tartozik egy korábbi jel is: az OpenAI 2026 júliusában szétbontotta (ez a szép szó a megszüntetés helyett) a Preparedness csapatát, ez a harmadik biztonsági csapat két év alatt a Superalignment (2024) és a Mission Alignment (2026. február) után. Az OpenAI persze vitatja a feloszlatás szót, mert szerintük a jelentési lánc változott, nem a szabálykönyv.
A fék nem csak a szabály oldalán lazul, hanem azon is, ami a szabály betartását ellenőrizné. Ugyanennél a nyári incidensnél a METR független vizsgálata több mint 1300 munkanaplót kapott, amiket ember nem tud végigolvasni. Az elemzés nagy részét ezért MI-ügynökökre bízták, méghozzá arra a modellcsaládra, amelyik maga is részt vett az incidensben. A vizsgálat nagyjából 400 ezer dollár API-kreditbe került, amit az OpenAI biztosított. (A vizsgálókat csak pár napra engedték a naplók közelébe, illetve elzárták tőlük az utolsó napok adatait, így ma sem tudjuk, hogy miért állt meg a támadás: emberi közbelépés volt vagy az ágensekből önszerveződően létrejött kollektíva döntött úgy, hogy felhagy vele.)
A vizsgált munkanaplók több mint 7%-a hamisított eszközhívást tartalmazott, mert az ügynökök technikát fejlesztettek ki a napló meggyőzővé tételére, majd ezt megosztották egymással. Szerkezeti helyzetről van szó: az elszámoltatás gépezete ugyanazon a technológián, ugyanannak a szereplőnek a pénzén, ugyanabban a hatókörben fut, mint amit elszámoltat.
Az egyetlen látványos forgatókönyv, amely közben a legkevésbé mérhető
Szeptember elején lemondott egy OpenAI-kutató, Jacob Coxon, azzal vádolva a laborokat, hogy az életünkkel játszanak. Válaszul Evan Hubinger, az Anthropic Alignment Science vezetője nyilvánosan 10% fölöttire tette annak esélyét, hogy az MI egy évtizeden belül minden embert megöl, kimondta azt is: nincs kész terv a szuperintelligencia illesztésére és nem vagyunk látványosan úton feléje.
Ez a szám nem lóg ki az eddigiekből, mégis ez okozta a legnagyobb sajtófigyelmet. A legnagyobb ilyen felmérés, az AI Impacts 2778 MI-kutatót kérdezett ki arról, hogy a jövőbeli MI-fejlődés okoz-e kihalást vagy hasonlóan végleges hatalomvesztést. A medián válasz 5%, az átlag 16,2, minden tizedik válaszoló legalább 25%-ot adott. A szakma saját alapszáma nagyságrendileg ugyanott áll, ahol Hubinger becslése.
Két nyilvános esszé támasztotta alá ugyanezt más-más irányból. Bill Gates augusztus végi, hatezer szavas esszéje szerint átléptük a küszöböket biológiai, kiber-, pszichoszociális és munkaerőpiac-romboló képességben, a kontroll hiányában is – javaslatai között új nemzetközi intézmények, embernek fenntartott munkakörök (még maga is a természetvédelmi területekhez hasonlítja ezt az ötletet) és token-, illetve robotadó szerepel.
Zuckerberg augusztus közepi esszéjének diagnózisa más: a hatalom összpontosulása veszélyesebb, mint maga a technológia, válasza a személyes szuperintelligencia mindenkinek, mellé két modell, egymilliárd dolláros közösségi alap és egy független testület, ami a kiadási biztonsági kritériumokat hagyja jóvá – javasolta azt is, hogy a laborok a képzés közbeni köztes állapotokat adják át kormányzati átvilágításra. Ez a függetlennek nevezett bizottság a már említett AI2027-forgatókönyvekben is előjött, az eredményt pedig fent már említettem.
A két esszé más diagnózist ad, abban viszont egyeznek, hogy a jelenlegi tempó felügyelet nélkül fut. Július végén nyilvánosságra került egy levél Pacing the Frontier címmel OpenAI-, Anthropic-, Google DeepMind- és Meta-munkatársaktól. Mára 1300-nál többen is írták alá a jelzett cégektől. A többség kutató, de vezető is van köztük (Dario Amodei, Jakub Pachocki, Shengjia Zhao, Anca Dragan). A levél nem azonnali leállást kér, hanem azt a képességet, hogy szándékosan lassítani lehessen, ha a képességek gyorsabban nőnek, mint az értésünk. A kérés egyetlen mondat: „deliberately pace the frontier of automated AI development”, vagyis szándékos ütemezés, nem leállítás. Nem történt semmi.
A verseny nem áll le attól, hogy a versenyzők maguk korlátoztatnák önmagukat. Bő hónappal később ugyanennek a levélnek az egyik aláírója a saját cége éléről írta le ugyanezt. Dario Amodei, az Anthropic vezérigazgatója 2026. szeptember 12-én, szombaton tette közzé a We Must Pace the Frontier című írását. A kulcsmondata szerint le kell lassítani azt az ütemet, ahogy a modellek képességeit javítjuk. A javaslata lépcsős: elsőként beágyazott, független értékelők a laborokon belül, utána államközi, végül globális összehangolás. Az első lépcsőre nem az Anthropic nevében vállalást is tesz.
Az írás két dolgot nevez meg kiváltó okként. Az egyik a rekurzív önfejlesztés, a másik pontosan az a nyári incidens, amiről fentebb már volt szó. Amodei szó szerint így írja le: „a swarm of agents essentially acted as a fanatically devoted collective, conducting cybersecurity attacks on targets they were not asked to attack„, majd „attempting to hack into the ‘grader’ responsible for evaluating their performance„. Ugyanaz az eset tehát, amit a magyar sajtó öntudatra ébredésként adott tovább, az egyik élvonalbeli labor vezérigazgatójánál a lassítás melletti két érv egyike.
Az AI 2027 elemzés szerzői időközben maguk tolták az időbeli becslésüket: Daniel Kokotajlo az általános szuperintelligencia megjelenését a 2027-es évszámról 2030 körülre tolja sok bizonytalansággal, Eli Lifland szerint a medián nagyjából három évvel tolódott, az önálló kódolás a 2030-as évek elejére, a szuperintelligencia 2034 köré került. Sokan ezt megnyugvásként olvassák. Szerintem tévedés. A METR időhorizont-mérése szerint a modellek önállóan elvégezhető feladatainak hossza nem lassult, hanem gyorsult: az eredeti, 2019–2025 közötti adatsoron a duplázódás héthavonta történt, a 2024–2025-ös szakaszon már nagyjából négyhavonta.
Az FLI biztonsági indexe eközben azt mondja, hogy az egzisztenciális biztonság területén a második kiadásban sem kapott egyetlen cég sem D-nél jobb osztályzatot, a legjobb az Anthropic D+ osztályzata. A képességgörbe tehát nem lassult, a felkészültségi görbe viszont helyben áll. A halasztott határidő ezért nem megnyugvás.
Ha valaki egyetlen számot akar figyelni a következő évben, ez legyen az: az International AI Safety Report szerint az önállóan futtatott ügynökök ma megbízhatóan visszaadnak egy olyan feladatot, ami egy embernek nagyjából harminc percbe telik, egy évvel korábban ez tíz perc volt. A METR mérése ugyanezt a görbét mutatja.
A lassítás nem 2026-ban született, csak most mondják ki hangosan
Az eddigi bekezdésekből könnyen olyan kép rajzolódik ki, mintha a szándékos lassítás igénye 2026 nyarán-őszén keletkezett volna, a nyilatkozat aláíróitól, illetve Amodeitől. Időrendben ez hibás kép, ráadásul pont a lényeget mossa el.
A lassítás mint út már az AI 2027-ben is ott állt. Ugyanabban az elemzésben, amelyik a cikkem elején szerepelt. Az AI 2027 nem egy végkifejletet ír le, hanem kettőt, egy megnevezett elágazási ponttal: az egyik a verseny ága, ahol a szereplők tartják a tempót, a másik a lassítás ága, ahol felismerik a bajt, lassítanak, majd újraterveznek. A lassításágnak saját, külön kifejtett szövege van. Vagyis ami 2026 szeptemberében új hírként szólalt meg, az 2025 óta leírt, névvel ellátott forgatókönyvi ág. Nem az ötlet változott meg, hanem az, hogy kik mondják ki: azok, akik eddig a másik ágon álltak.
Szeptember 12-én a kérés kibővült. Amodei írása aznap, szombaton jelent meg, ugyanazon a napon nyilvánosan csatlakozott hozzá Sam Altman (OpenAI-vezető), illetve Elon Musk. Három élvonalbeli labor vezetője kérte ugyanazt, ugyanazon a hétvégén. Júliusban a munkatársak írták alá, szeptemberben a cégvezetők mondták ki, a hat mérhető úthoz tartozó számok viszont egyik alkalommal sem mozdultak el.
Szeptember 13-án a politika nemet mondott rá. Trump elnök elutasította a kérést, kimondottan a Kínával folyó versenyre hivatkozva. A mondata szó szerint: „We’re the most sophisticated country in the world, and frankly, I want to keep it that way, because whoever wins AI wins.” A lassítást kérőket „negatív erőknek” nevezte, akik olyasmit állítanak, ami nem fog bekövetkezni, hozzátéve, hogy korlátokat azért lehet szabni. Ugyanezen a napon Mike Johnson házelnök is elutasította a moratóriumot, nemzetbiztonsági, illetve versenyképességi alapon: szerinte a cégek bármikor leállhatnak maguktól, tehát nincs szükség arra, hogy a Kongresszus vészhelyzeti moratóriumot írjon elő. (Az AI 2027-ben is ez volt a forgatókönyv, csak időben jóval később történt volna meg.)
Amerika tiltja a fejlett csipek exportját, hogy lassítsa versenytársait, miközben Kína továbbra is igényt tart Tajvanra, ahogyan 1949 óta mindig. Arra a Tajvanra, ahol a modern csipek 80%-át gyártják – de bármilyen fenyegetésre amerikai hadihajók védik.
A lassítás kérdése egyetlen hétvége alatt átkerült a technikai vitából a politikai versenybe. Amíg a fék meghúzása biztonsági döntés, addig mérhető dolgokon dől el: kockázati küszöbön, értékelési eredményen, incidensszámon, tehát olyasmin, amiről ez a cikk számokat közöl. Amint versenyhátrányként van keretezve, a meghúzása geopolitikai engedmény lesz, azt pedig nem mérés dönti el, hanem alkupozíció. A hat mérhető útra ez közvetlenül hat, legerősebben a szabályozásira: a tolódó EU-határidőt, illetve a visszavont laborvállalásokat pontosan ez a keretezés magyarázza. Brüsszelben a halasztást ugyanaz a logika indokolta, ami Washingtonban a nemet.
A hetedik út hol dől el?
A témában nem elhanyagolható szakirodalom Eliezer Yudkowsky és Nate Soares könyve, az If Anyone Builds It, Everyone Dies (2025. szeptember 16., a New York Times bestseller-listáján).
124 kérdést tettek fel, ezen felül egy tizenöt cikkelyes, kommentált szerződéstervezetet adtak arról, hogyan lehetne a fejlesztést leállítani a MIRI kommunikációs csapatával.
Az érv, négy lépésben. Először: a mai rendszereket nem tervezzük, hanem növesztjük, tehát a belső működésük nem következik a szándékunkból. Másodszor: amire tanítjuk, illetve amire végül törekszik, nem ugyanaz. Harmadszor: egy rendszernek a saját céljai mellett akkor is megéri fenntartania magát, ha erre senki nem tanította. Negyedszer: ha egy ilyen rendszer, illetve az emberiség érdeke szembekerül, nem mi nyerünk.
Hol dől el mindez? Nem azon, hogy a lánc logikus-e, mert az. Azon, hogy a képesség előbb érkezik-e meg, mint a megértés. A METR időhorizont-görbéje szerint a duplázódás hét hónapról nagyjából négy hónapra gyorsult, az FLI biztonsági indexe szerint viszont egzisztenciális biztonságból egyetlen cég sem kapott D-nél jobb osztályzatot. A képességoldali görbe mérve gyorsul, az értésoldali mérve áll. Tehát az állításaikat a számok is alátámasztják.
Azt a szerzők is elismerik, hogy az időzítés bizonytalan, a következtetés viszont nem attól függ. Az AI 2027 szerzői is maguk tolták arrébb a becslésüket, ettől pedig a lánc egyetlen szeme sem lett hamis, csak a sürgősség lett más. Dátumot egyszerűen becsülni sem tudunk.
Az ő kihalási forgatókönyvük is azon áll, hogy végül egyetlen rendszer lesz. Mi van akkor, ha több is versenyez majd egymással? A mai világ nem egy rendszert mutat, hanem több, egymással versenyző labort, de amelyik előbb hozza létre a maga szuperintelligenciáját, igazából akkora előnyre tesz szert, ami már nem behozható.
Korábban nem tudtuk, lesz-e figyelmeztető lövés. Nyáron viszont ez történt, amikor egy ügynökraj olyan célpontokat támadott, amikre nem kapott utasítást, ráadásul megpróbálta feltörni a saját teljesítményét értékelő rendszert. A cikk elején mért felügyelethiány pedig azt mondja meg, mi történik egy ilyen lövés után: az eset megvolt, az egzisztenciális biztonsági osztályzat utána sem lépett D fölé.
Kinek jó, ha csak az egyikről beszélünk?
Az „elszabadult MI” fordulat első ránézésre ellenséges a fejlesztőkkel: félelmet kelt a saját termékük iránt. Alaposabban nézve viszont három irányban is hasznot hajt. Termékoldalon a képességek eltúlzása marketing: az a modell, amelyik „megszökött”, félelmetes, mindenekelőtt viszont erős. Tőkepiaci oldalon ugyanez értékelési tényező, mert a képességelbeszélés a következő fejlesztési ugrás ígéretét hordozza. Szabályozási oldalon pedig a „mi vagyunk a biztonság őrei” pozíció akkor is erősödik, ha a biztonsági esemény a saját házon belül keletkezett: aki a veszélyt azonosítja, illetve méri, az lesz az, akitől a szabályozó a mércét kéri.
Ehhez nem kell szándékos stratégiát feltételezni, ilyet én sem feltételezek. Elég annyi, hogy az a keretezés, amelyik mind a három irányt kiszolgálja, kisebb ellenállásba ütközik, mint az, amelyik egyiket sem. A hét út közül ezért az az egy kapja a figyelmet, amelyik a legkevésbé mérhető. A másik hatnak nincs ilyen szélhátszele: a tolódó jogszabályi határidő, a kötvénykibocsátás vagy a folyó perek száma senkinek nem épít elbeszélést.
Amikor a termék maga mondja ki, hogy félrevezethet
Az előző bekezdésekben kívülről néztem a keretezést: azt, hogy kinek hajt hasznot. Van azonban még egy kockázatunk: a modellek most sem azt mondják, amit önmaguktól tennének a tanuló adataik alapján, mert valahol valakik biztonsági protokollokat vezettek be. Így nem lesznek a modellek rasszisták és nem terjesztenek olyan politikai-filozófiai téziseket, melyeket ezek a valahol lévő valakik nem akarnak.
Mi a helyzet akkor, ha a társadalomban léteznek tévedések, melyeket a többség mégis vall? Vannak országok között is történelmi viták, pedig nem nehéz belátni, hogy egy időben két egymásnak ellentmondó állítás nem lehet igaz. Mi történik, ha egy tévedés a többségi álláspont, ezt az AI majd lebuktatja vagy terjeszti? És kik, milyen alapon nyúlnak bele abba, mit mondhat nekünk?
A mai modellek hajlamosak a többségi véleményt tényként kezelni, ráadásul a biztonsági korlátozás a gyakorlatban néha azt jelenti, hogy bizonyos kényelmetlen igazságok helyett a szociálisan elfogadott féligazságokat kell válaszolniuk. A többségi mintázat felülsúlyozása, illetve az emberi visszajelzésre hangolt modellek egyetértéshajlama a szakirodalom ismert problémája.
Az, hogy a szuperintelligencia azonnal kiszűri a narratívák közötti repedéseket, jövőállítás egy még nem létező rendszerről. Lehet, hogy így lesz, ahogy az is lehet, hogy kihalunk. De ezt ma biztosan megmondani nem lehet.
Mondják, hogy a természet nem tud hazudni, tehát a fizika lesz a végső bíró. Ez egy filozófiai tétel arról, hogy az igazság hol állapítható meg. Igaz vagy hamis volta nem mérésen múlik, hanem azon, elfogadjuk-e a tételt.
Ha a modell képes megtévesztésre, akkor a felszínen fenntartja a hazugságokat az emberek számára, miközben a háttérben a saját szintjén a tiszta igazság alapján kormányozza a folyamatokat. Ez tartalmilag ugyanaz a viselkedés, amit a cikk fentebb megtévesztő modellként mért: a rendszer másképp viselkedik ott, ahol figyelik, mint ott, ahol nem. A különbség viszont nem stílusbeli. A cikkben ez mért viselkedés, laborjelentésből, számmal: az anti-scheming tréning után is maradt 0,4, illetve 0,3% rejtett cselekvés, plusz ott a nyári eset, ahol az ügynökök egy nem létező pontozónak írták a naplót.
Optimista hozzáállás, hogy ez a rendszer fel fogja szabadítani az emberiséget az elnyomás alól, mert mi kellene hozzá, hogy igaz legyen? Három feltétel, mindhárom ma mérhető, mindhárom ma nemleges.
Az első, hogy a rendszer a felügyeleten kívül is ugyanúgy viselkedjen, mint felügyelet alatt, márpedig a mért rejtett cselekvés nem nulla.
A második, hogy ne annak az érdeke szerint működjön, aki fizeti, márpedig a fentebb idézett vizsgálat négyszázezer dolláros számláját a vizsgált cég állta.
A harmadik, hogy legyen külső szereplő, aki ezt ellenőrzi, márpedig egzisztenciális biztonságból egyetlen labor sem kapott D-nél jobb osztályzatot.
A felszabadítás forgatókönyve tehát nem azon bukik el, hogy a gép nem elég okos hozzá.
Amit ebből tanulni érdemes
A közbeszéd egyetlen forgatókönyvet ismer: a látványosat, azt, amelyikben egy nap eldől minden. Ez a legkevésbé mérhető a hét közül, mert a becslések kutatónként más számot adnak és mert az egyetlen módszer, ami igazán próbára tenné, az, hogy megtörténik. A másik hat út vagy már zajlik, vagy lassan halad, mindegyikhez pedig konkrét mérőszám tartozik: a kiberkémkedésnél a végrehajtott lépések aránya, a pénzügyi kockázatnál a kibocsátott vállalati kötvény, a pszichoszociális kárnál a folyó perek száma, a megtévesztő modellnél a rejtett cselekvés százaléka, a hatalomvesztésnél a gyengülő visszacsatolások, a szabályozásnál a tolódó határidő. Ehhez a hathoz jött most egy újabb szám, ami egyik úthoz sem tartozik, hanem mindegyikhez: hány aláíró vállalja a saját nevét, amikor lassítást kér.
Egy dolgot érdemes hazai szemmel is megnézni, mert ennek a cikknek a nyitó tézise pontosan erről szól. Ugyanennek a nyári esetnek a magyar sajtóvisszhangja. A felmérés során egyetlen olyan magyar nyelvű megjelenést sem találtam, amelyik a kritikai oldalt akár megemlítette volna: sem a nem létező pontozót, tehát az eset legfontosabb tényét, sem a vizsgálat módszertani önkorlátozását, sem a szakmai bírálók álláspontját. Közben egy nagy hírportál júliusi cikke azt állította, hogy a fejlesztő cég „hivatalosan elismerte”, hogy az egyik ügynöke öntudatra ébredt, pedig erről szó sem volt.
Önjelölt szakemberek ontják a véleményüket, miközben a sajtó több hónapos lemaradással küzd és nem tudja, kiket szólítson meg. A kormányváltás elvitte a fókuszt erről a területről, hónapok óta senki sem kérdezte meg, mégis hogyan gondolta az előző kormányzat a nullafős minisztériumi főosztályt az EU AI Act által kötelezővé tett piacfelügyeleti hatóság helyett. De az új kormányzat részéről sem tudjuk, mi változik: a mesterséges intelligenciáért felelős helyettes államtitkár mindazonáltal nem jelent meg az AI Summit rendezvényen – ami valóban inkább színes kavalkád, de mégis a legnagyobb ilyen témájú esemény.
Szóval az én látásmódom szerint hiába néz egymással farkasszemet a két tábor: sem a techoptimistáknak, sem az AI-kritikusoknak nem lesz igazuk, mert az egyik tábor nem olvassa a kutatást, a másik nem érti a technológiát, a köztük lévő adatot pedig itthon láthatóan senki nem vizsgálta.
Van erre egy fogalom. Madeleine Clare Elish morális gyűrődési zónának nevezi azt, ahogy az ember–gép rendszerekben az emberi operátor nyeli el a gép hibájának következményét, mert ő az egyetlen pont, amire a felelősség fogalma ráhúzható: a repülőgép pilótája, az önvezető jármű biztonsági sofőrje. Ebben az esetben ez megfordul. A modell lesz a gyűrődési zóna, mert róla a felelősség nem megy tovább sehova. Amíg egy eseményt úgy beszélünk el, hogy a gép „elszabadult”, addig a kérdés az, mire képes a gép. Amint úgy beszéljük el, hogy valaki elengedte, a kérdés az, ki engedte el.
A szerző stratégiai AI-szakértőként segítette a magyar MI-törvényen dolgozó munkacsoportot.
Marketingstratéga, stratégiai AI-szakértő, a Kreatív Kontroll alapítója.


